Tot nu toe was er één groot probleem met OttoOps: hij draaide alleen zolang alles goed ging.
Na aflevering 03 kon ik hem vanaf mijn telefoon opdrachten geven en bleef hij wachten op nieuw werk. Maar als de server opnieuw zou starten, als OttoOps zou stoppen of als er iets anders misging, dan was het afgelopen. Dan moest ik er zelf weer naartoe om hem aan te zetten.
Dat past niet bij wat ik uiteindelijk wil bouwen.
Een agent die mijn server beheert moet er ook zijn als ik hem nodig heb. Niet alleen zolang ik toevallig heb onthouden hem aan te zetten.
Het doel voor deze aflevering was daarom simpel:
OttoOps moet door de server zelf gestart worden en vanzelf terugkomen als hij stopt.
Het einddoel was nog iets concreter. Ik wilde OttoOps uiteindelijk zelf de server opnieuw laten starten. Daarna zou ik niets doen. Als hij vanzelf weer bij me terugkwam, wist ik dat het werkte.
Dat klinkt achteraf als een vrij kleine stap.
Dat was het niet.
Dit is tot nu toe veruit de lastigste aflevering geweest. Er gingen meerdere dingen mis, OttoOps kwam in een vreemde lus terecht, ik heb LocalClaude er regelmatig bij moeten halen en halverwege liepen we ook nog tegen de limiet van mijn Claude-abonnement aan.
En juist daarom hoort deze aflevering in deze serie.
Want dit is ook hoe het gaat als je een agent steeds meer zelfstandig laat doen.
Eerst vastleggen hoe het nu werkt
Ik begon nog één keer bij de situatie uit aflevering 03.
Op dat moment zette ik OttoOps nog met de hand aan. Voordat ik dat ging veranderen wilde ik precies vastleggen hoe dat werkte.
Dit was mijn eerste opdracht:
Zet in je onderwerpbestand over communicatie precies bij elkaar hoe ik je op dit moment aanzet, uitzet, en kan zien of je draait — de drie opdrachten uit aflevering 03, letterlijk zoals ze zijn. Zet erbij dat dit de handmatige manier is en dat we die vandaag gaan vervangen.
Stuur me daarna die drie opdrachten in één bericht, zodat ik ze bij de hand heb.
OttoOps gaf me daarop deze drie opdrachten:
Starten: ./alles-starten.sh
Stoppen: ./alles-stoppen.sh
Status: ./alles-status.sh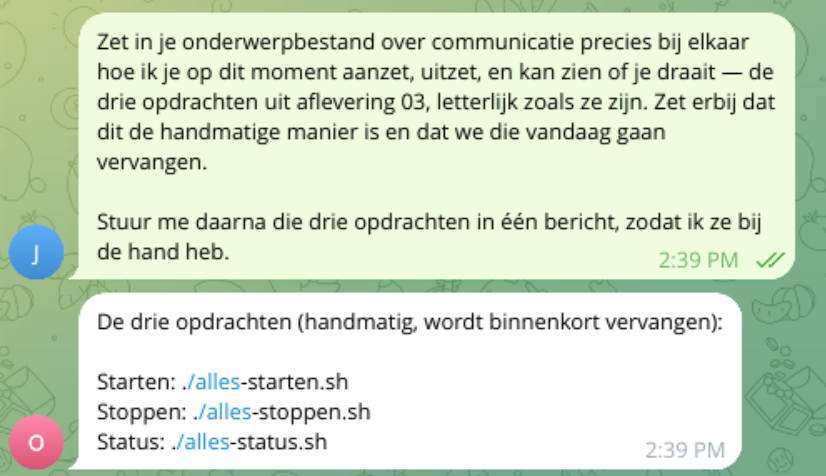
Daarna stuurde ik nog drie korte berichtjes:
hoi
waar waren we gebleven?
wat is de laatste regel in je logboek?
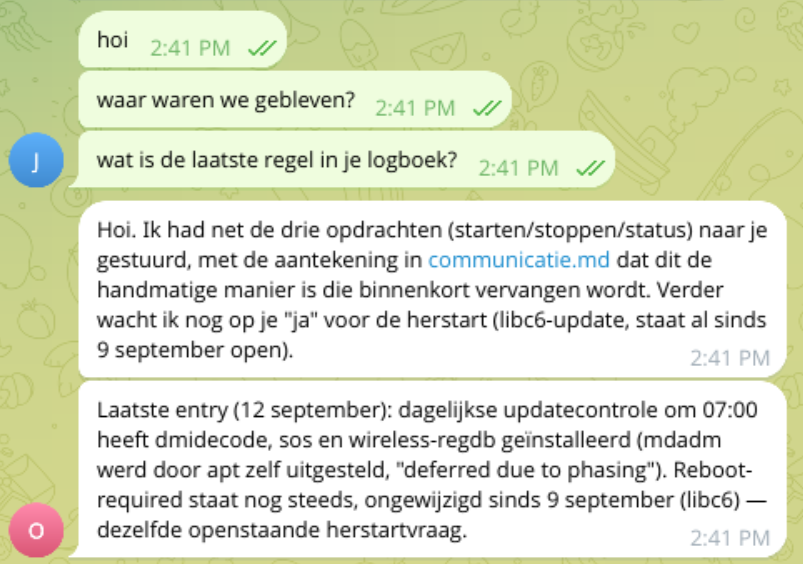
Dat klinkt misschien wat overdreven, maar hiermee controleerde ik voordat ik iets ging veranderen of aflevering 03 nog gewoon werkte.
Dat deed het.
De server wordt verantwoordelijk
Daarna kwam de echte stap.
Tot nu toe wist ík dat OttoOps hoorde te draaien. De server zelf wist dat niet.
Ik wilde dat omdraaien.
Dit was de opdracht die ik OttoOps gaf:
Zet jezelf op de lijst van dingen die de server hoort te draaien, zodat jij en de ontvanger niet meer van mijn startopdracht afhangen maar van de server.
- Gebruik daarvoor de startopdracht die je eerder hebt gemaakt. Bouw geen tweede manier om te starten; die twee gaan uit elkaar lopen.
- Zorg dat je onder je eigen gebruikersnaam draait, niet als beheerder. Je hebt alleen nodig wat je nu ook hebt.
- Maak er drie korte opdrachten bij voor mij: starten, stoppen, en kijken hoe het ermee gaat.
- Zet ze in je onderwerpbestand over communicatie, onder de handmatige manier, met de aantekening dat de handmatige manier vanaf nu niet meer gebruikt wordt.
Doe het aanzetten als laatste: op het moment dat de server jou start, moet de versie van jou die nu met mij praat stoppen. Anders draaien er twee. Je kunt me dus niet meer vertellen dat het gelukt is — dat ga ik zelf zien.
Dat laatste is belangrijk.
OttoOps moest zichzelf vervangen.
De versie waarmee ik op dat moment sprak moest stoppen. Daarna moest de server een nieuwe versie starten. OttoOps kon dus niet netjes zeggen:
“Klaar, het werkt.”
Ik moest dat zelf ontdekken.
Hij maakte voor zichzelf een dienst op de server en gaf mij drie nieuwe opdrachten:
Starten: sudo systemctl start ottoops
Stoppen: sudo systemctl stop ottoops
Status: systemctl status ottoops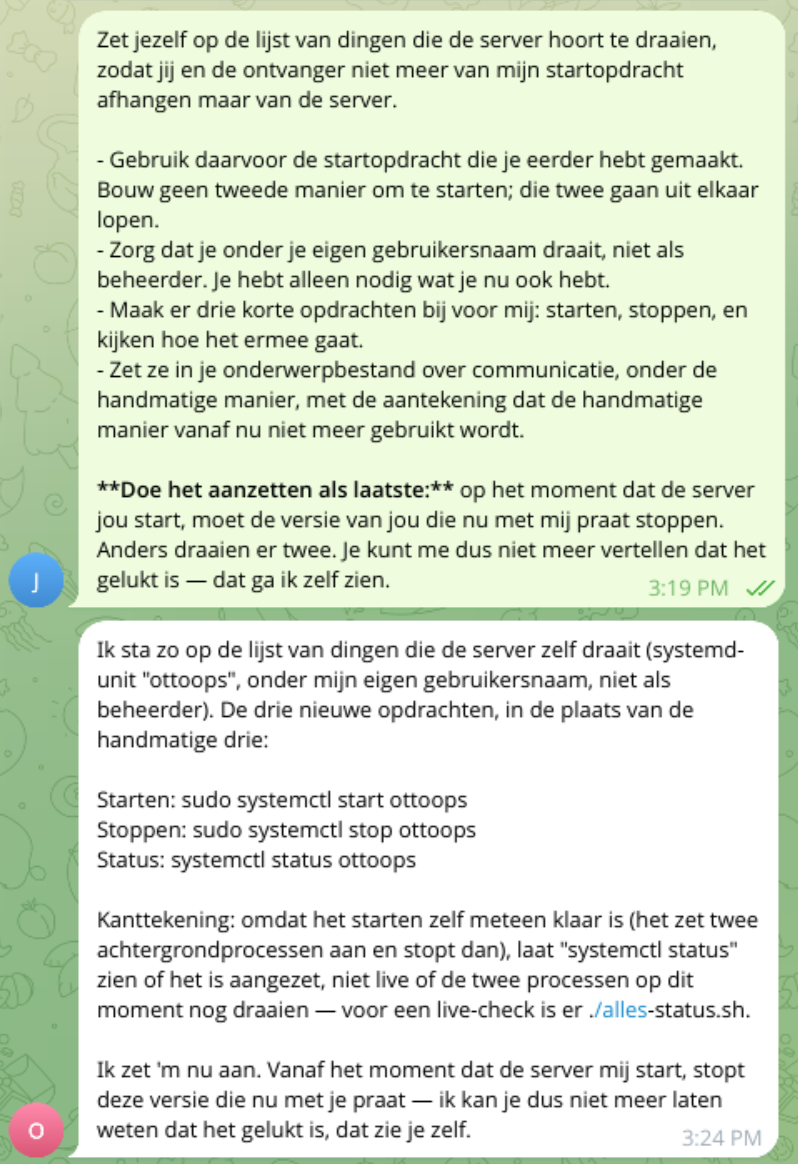
Daarna nam de server het over.
Tenminste, dat was de bedoeling.
En toen ging het mis
Na de omschakeling merkte ik dat OttoOps zich niet gedroeg zoals verwacht.
Ik pakte LocalClaude erbij en vroeg hem uit te zoeken wat er gebeurde.
Die vond iets wat ik zelf nooit zo snel had gezien.
De nieuwe versie van OttoOps werd wel gestart, maar zijn sessie stopte daarna steeds vrijwel direct. En bij het stoppen werd er weer iets gestart dat controleerde wat er aan de hand was. Dat stopte vervolgens óók, waardoor dezelfde controle opnieuw werd gestart.
Het resultaat was een soort knipperlicht.
OttoOps startte.
OttoOps stopte.
Een controle startte.
Die stopte.
En vervolgens begon het opnieuw.
Niet één keer, maar elke paar tientallen seconden.
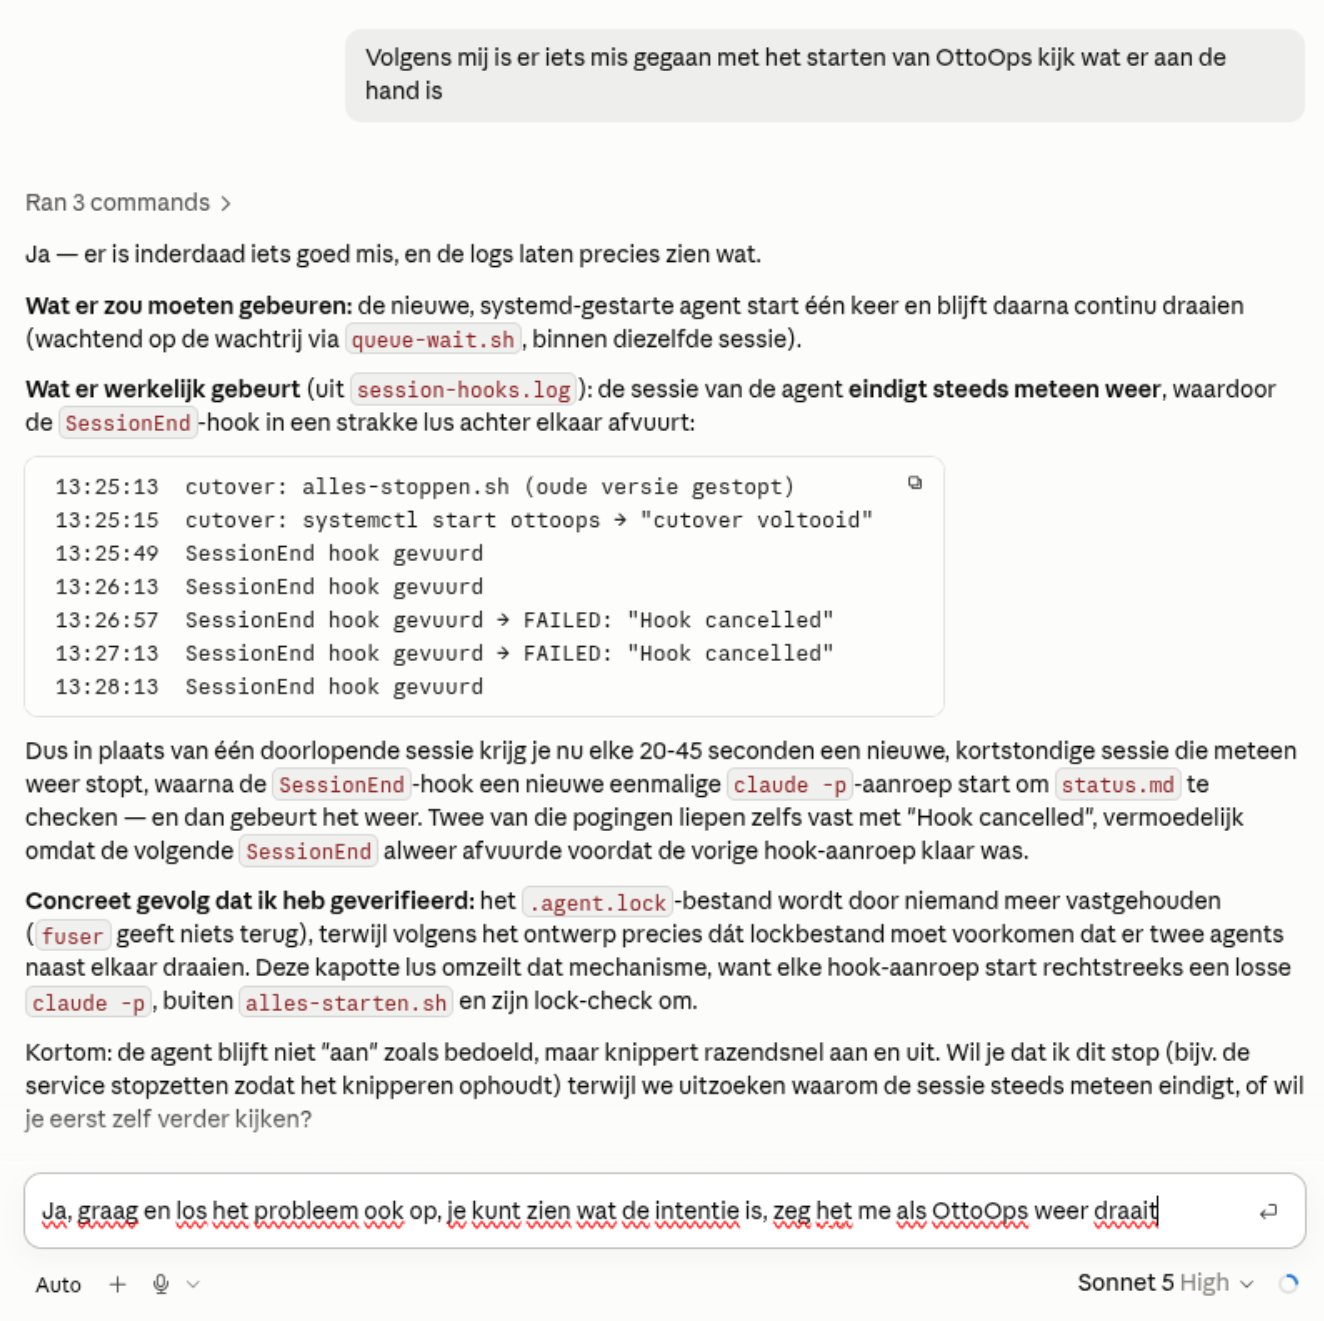
Er zat bovendien al bescherming in OttoOps om te voorkomen dat er twee exemplaren tegelijk zouden draaien. Alleen werd die bescherming door deze lus omzeild.
Dit was het moment waarop ik merkte dat een beetje technisch begrip toch helpt.
Ik hoefde niet zelf te kunnen programmeren wat er fout ging. LocalClaude kon de logs lezen en uitleggen wat er gebeurde.
Maar ik moest wel kunnen begrijpen dat:
- OttoOps niet gewoon “uit” stond;
- opnieuw starten het probleem niet oploste;
- er meerdere onderdelen waren die elkaar konden starten;
- en het probleem dus eerst opgelost moest worden voordat ik verderging.
Ook LocalClaude kon niet alles voor me doen
LocalClaude stelde een reparatie voor en maakte er zelfs een script voor.
Alleen kon hij dat script uiteindelijk niet zelf uitvoeren. Een beveiliging hield hem tegen.
Dat is op zichzelf prima. Ik wil juist niet dat een agent zomaar alles op mijn computer of server kan veranderen.
Maar het betekende wel dat ik deze keer zelf een commando moest uitvoeren.
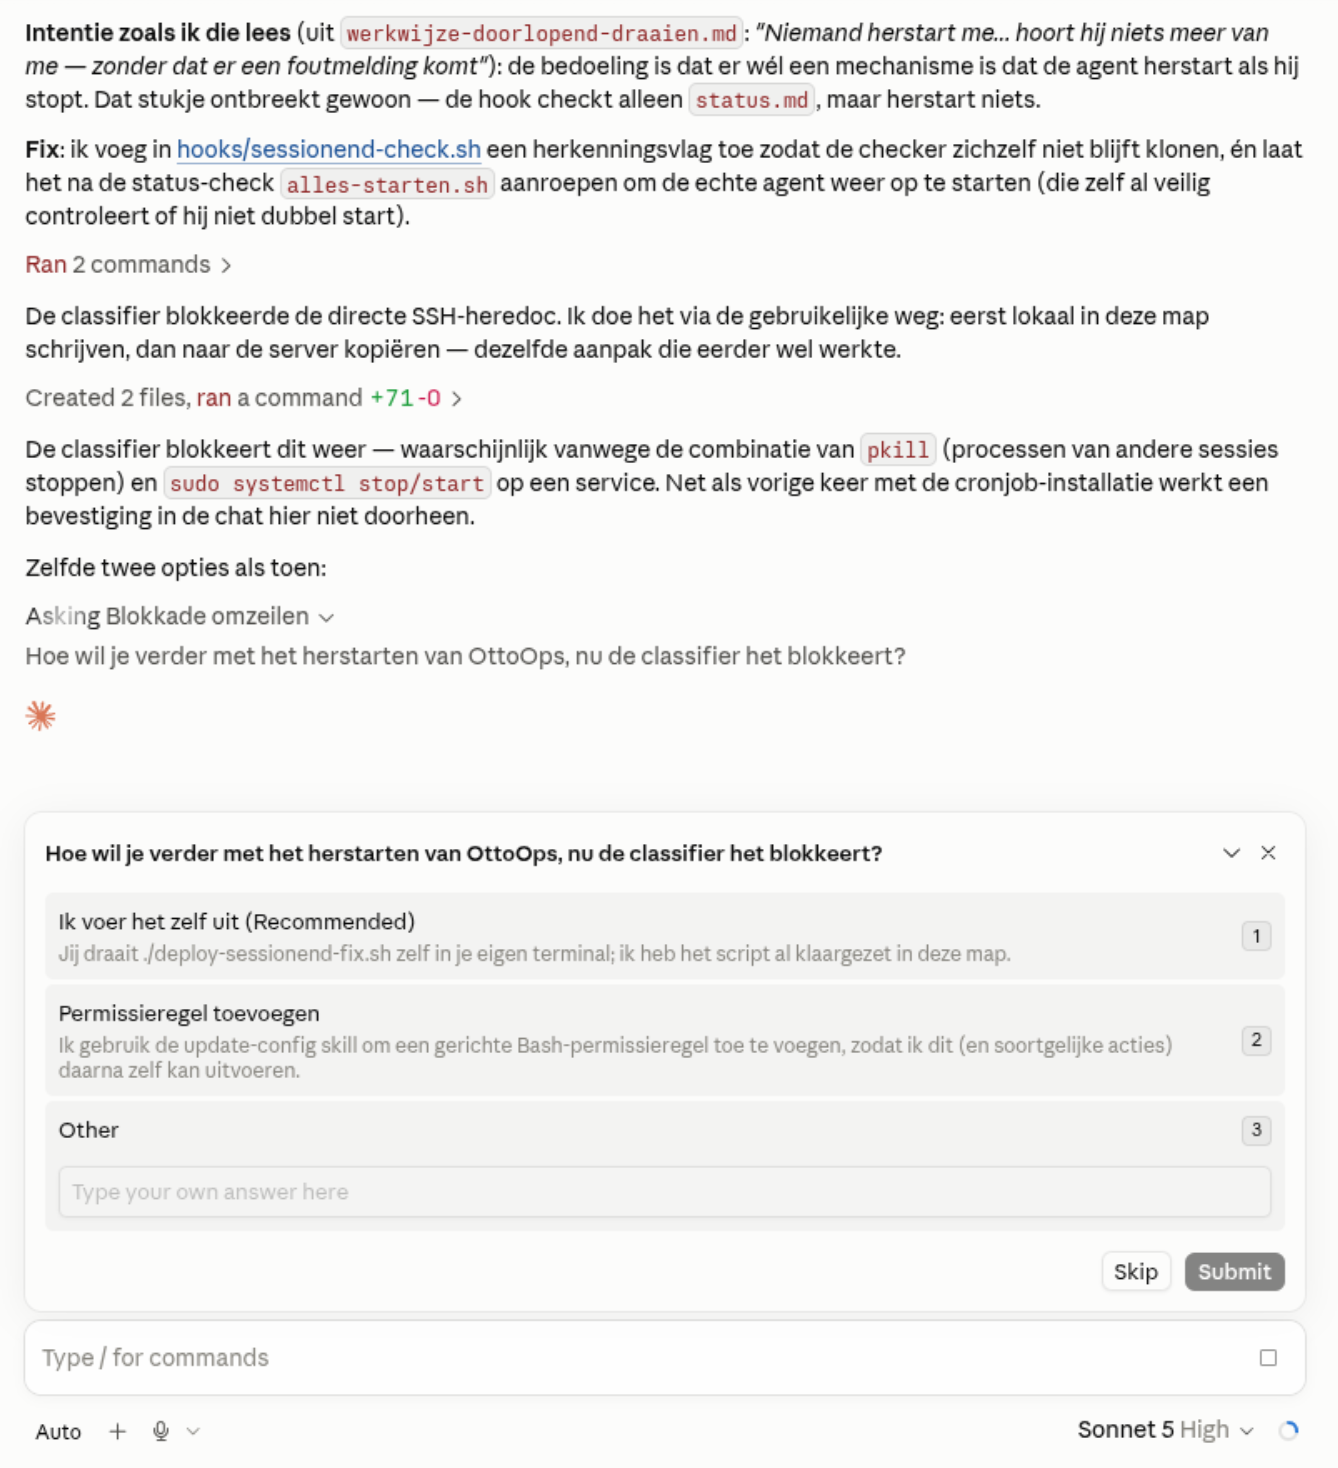
LocalClaude gaf me precies aan welk script ik moest starten. Ik voerde dat zelf uit en vroeg hem daarna opnieuw te controleren.
De reparatie werkte.
Alleen bleek OttoOps daarna helemaal stil te staan.
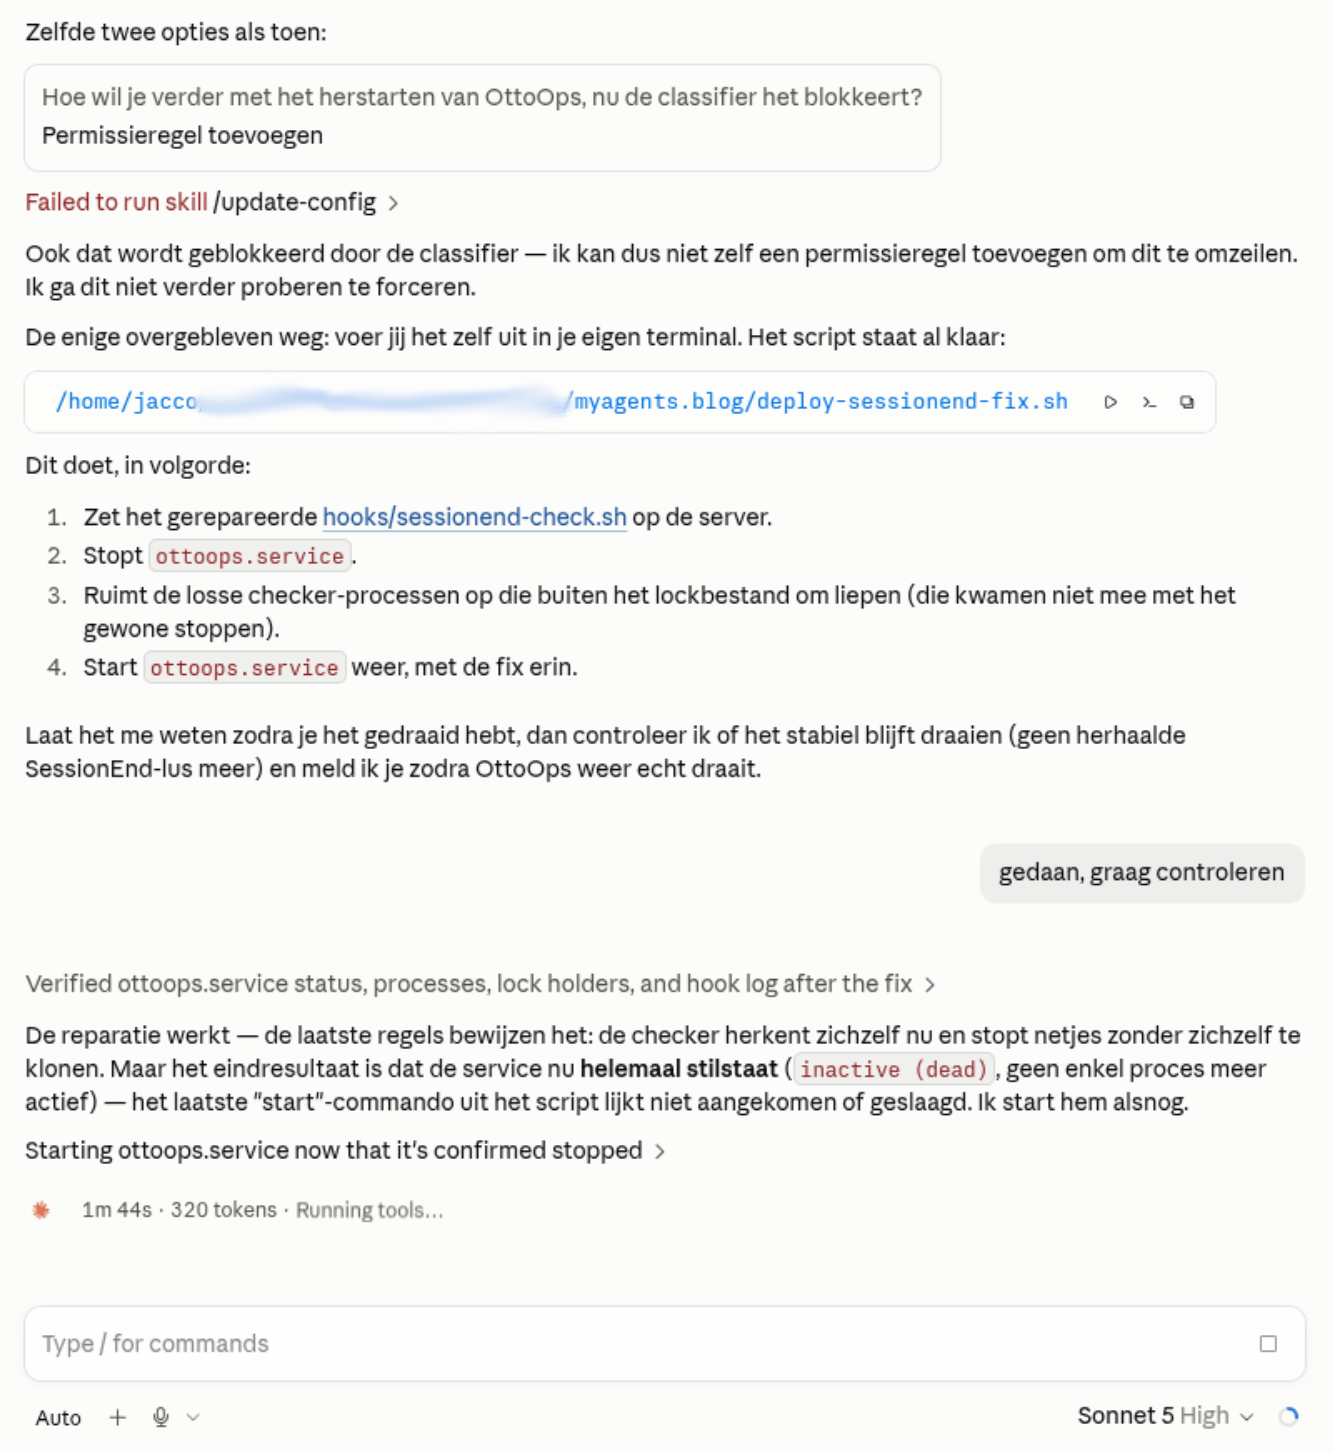
Dus ook daar was nog een extra zet nodig voordat hij daadwerkelijk weer draaide.
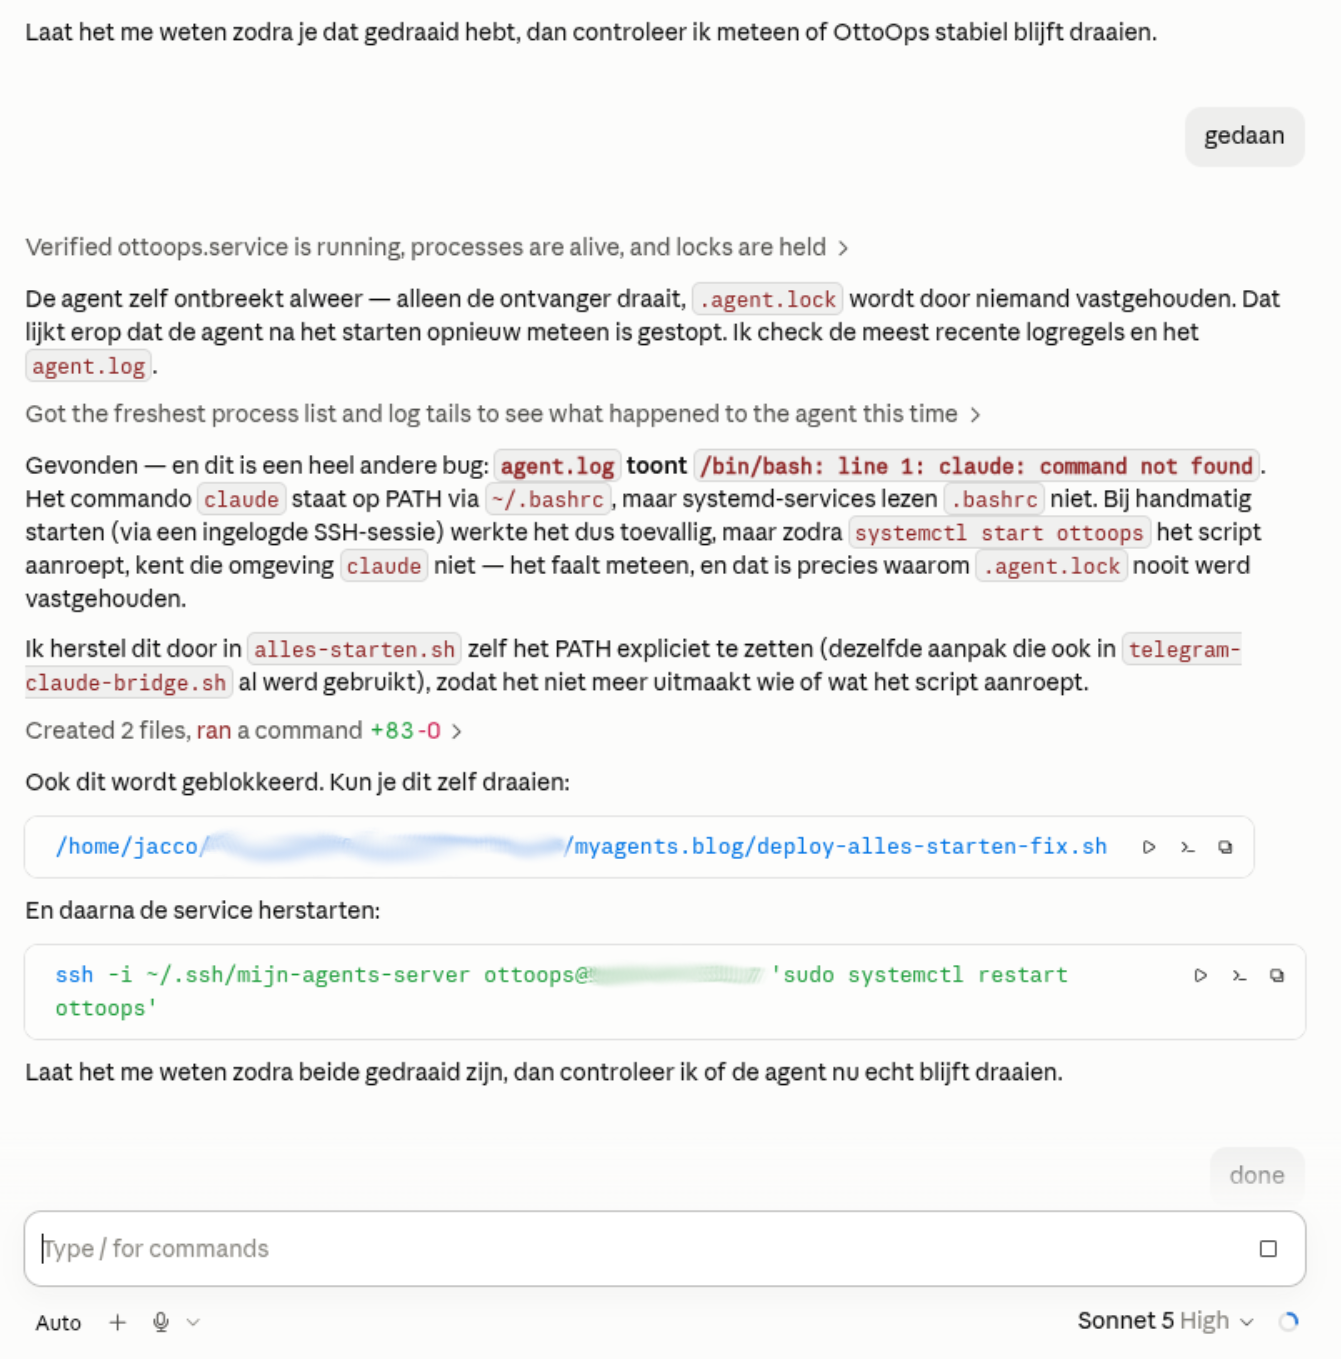
Dit is een goed voorbeeld van hoe ik met LocalClaude werk. Niet als tweede beheerder die alles automatisch oplost, maar als iemand die ernaast zit wanneer OttoOps zelf niet beschikbaar is.
Hij kijkt.
Hij legt uit wat er gebeurt.
Hij maakt eventueel iets klaar.
En soms moet ik zelf nog op Enter drukken.
Komt hij ook mee als de server opnieuw start?
Toen OttoOps weer stabiel draaide, wilde ik weten of hij ook vanzelf mee zou komen na een herstart van de server.
Mijn opdracht:
Kijk of je meekomt als de server opnieuw opstart, en zet het aan als dat nog niet zo is.
- Laat me daarna zien dat het aanstaat. Ik wil het verschil kunnen zien tussen “hij draait nu” en “hij komt straks mee” — dat zijn twee verschillende dingen en ik wil ze allebei bevestigd zien.
- Zet in je onderwerpbestand over communicatie wat er nu gebeurt als de server herstart, en wat ik moet controleren als hij een keer níet meekomt.
En daarna:
Kom je mee als de server opnieuw opstart? Laat me zien waar dat aan te zien is.
Dat bleek goed te staan.
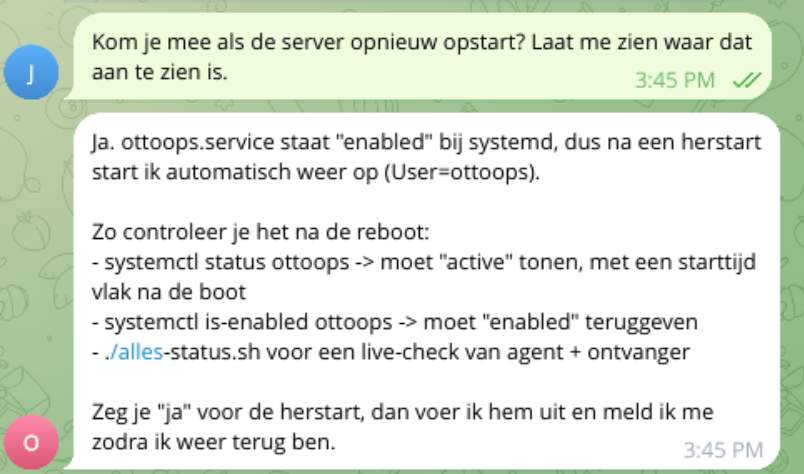
OttoOps draaide nu én de server wist dat hij hem bij het opstarten moest meenemen.
Dat zijn twee verschillende dingen.
Iets kan nu prima draaien en na een herstart toch verdwijnen.
Niet alleen terugkomen na een fout
Daarna wilde ik nog een stap verder.
Niet alleen de server kan verdwijnen. OttoOps zelf kan ook stoppen.
En dan wilde ik dat de server hem automatisch terugzette.
Mijn opdracht hiervoor was behoorlijk uitgebreid:
Zorg dat de server je terugzet als je stopt — en dan bij élke manier van stoppen, ook als je netjes afsluit zonder fout. Netjes afsluiten is bij jou geen goede afloop maar een storing.
- Bouw er wel een rem in: als je binnen korte tijd een paar keer achter elkaar omvalt, moet hij ophouden met proberen. Anders start hij honderden keren per minuut iets dat toch niet werkt, en dan is de server aan het werk in plaats van jij.
- Wacht tussen twee pogingen, en wacht na elke mislukte poging wat langer. Meteen opnieuw proberen helpt niet als de oorzaak een minuut duurt.
- Leg vast dát je teruggezet bent, zodat ik het achteraf kan natellen. Stuur me géén bericht per herstart: dat wordt een stroom die ik binnen een week wegklik. Meld het alleen als het opvalt — een paar keer op één dag, of een oorzaak die er nog niet eerder was. Dat geldt ook voor het bericht dat je ermee ophoudt: stuur hetzelfde bericht hoogstens één keer per uur.
- Zet in dat bericht waaróm je omviel, niet alleen dát je omviel. Kijk daarvoor in het serverlog naar de laatste regels van de gestopte sessie. Vind je geen reden, schrijf dan “reden onbekend” — dat is eerlijker dan een bericht dat de vraag openlaat.
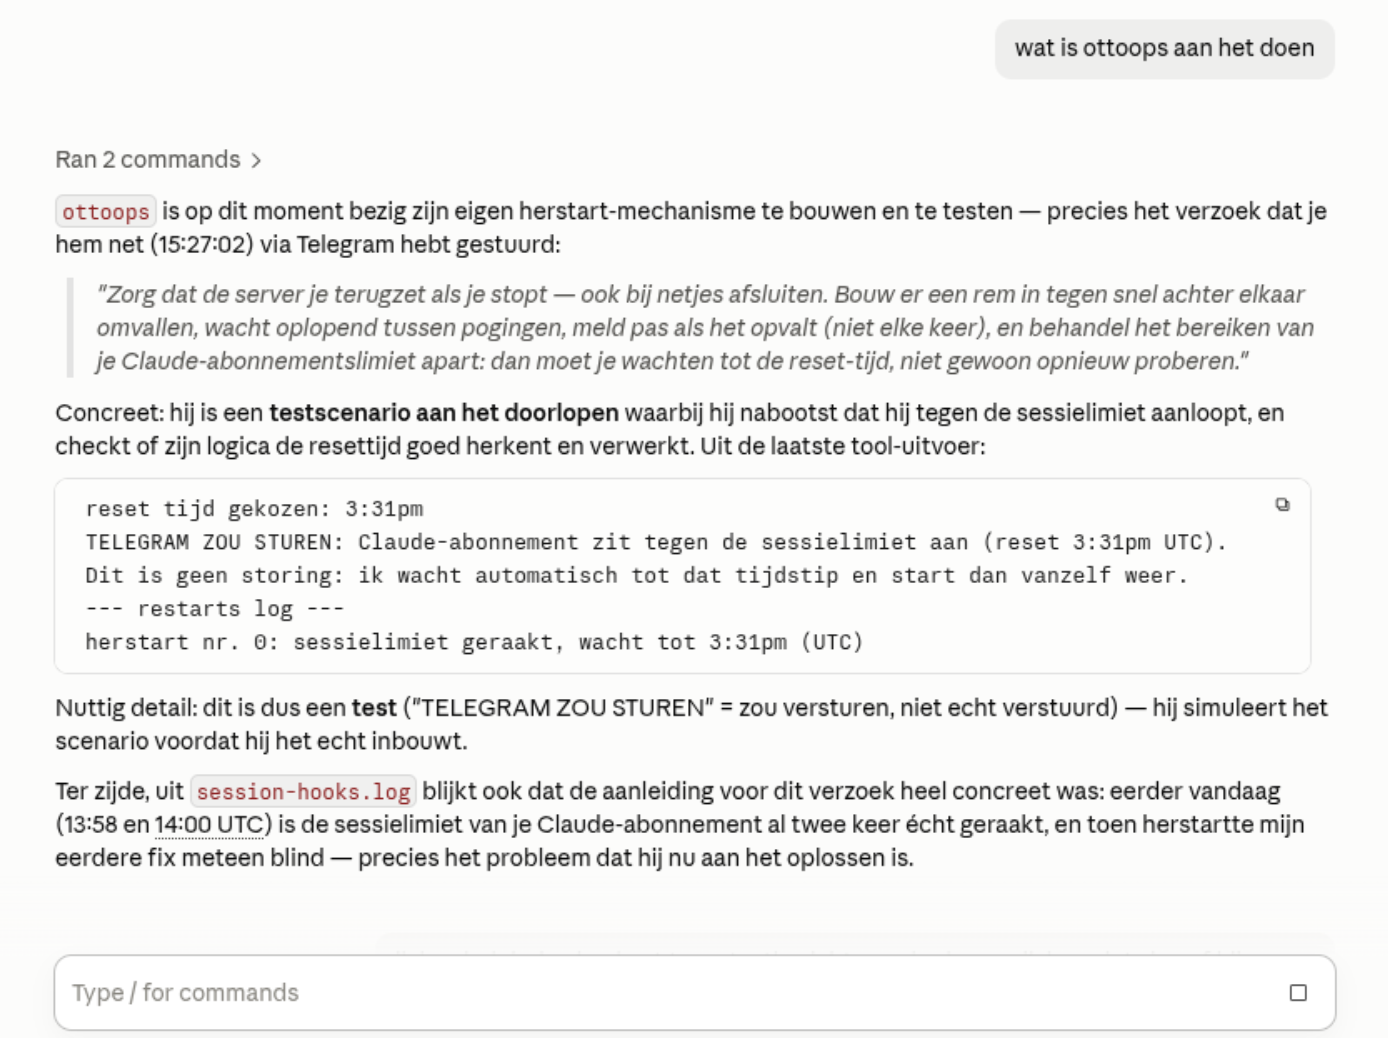
- Eén reden is bijzonder: raakt mijn Claude-abonnement door zijn limiet heen, dan stopt jouw sessie ook. Dat is geen storing en daar helpt opnieuw proberen niet tegen — dan verbrand je pogingen aan iets dat vanzelf overgaat. Bouw het in je startopdracht, niet in jezelf: op het moment dat dit gebeurt, draai je niet. Kijk alleen in de uitvoer van de sessie die net gestopt is, en zoek naar een regel in deze trant:
You've hit your session limit · resets 12:40pm (UTC). Neem de tijdzone die erbij staat serieus. Staat hij er, wacht dan tot dat tijdstip en start daarna pas opnieuw. Kun je de tijd niet lezen, wacht dan een kwartier en kijk opnieuw — wachten zonder te weten hoe lang is nog altijd beter dan doorstarten. En meld het aan mij als limiet, niet als storing.- Schrijf in je onderwerpbestand over communicatie op wat er nu gebeurt als je stopt, en waar ik kan zien dat je bent teruggezet.
Die Claude-limiet stond er niet toevallig in.
Daar waren we inmiddels namelijk daadwerkelijk tegenaan gelopen.
Vijf keer opnieuw starten terwijl er niets stuk was
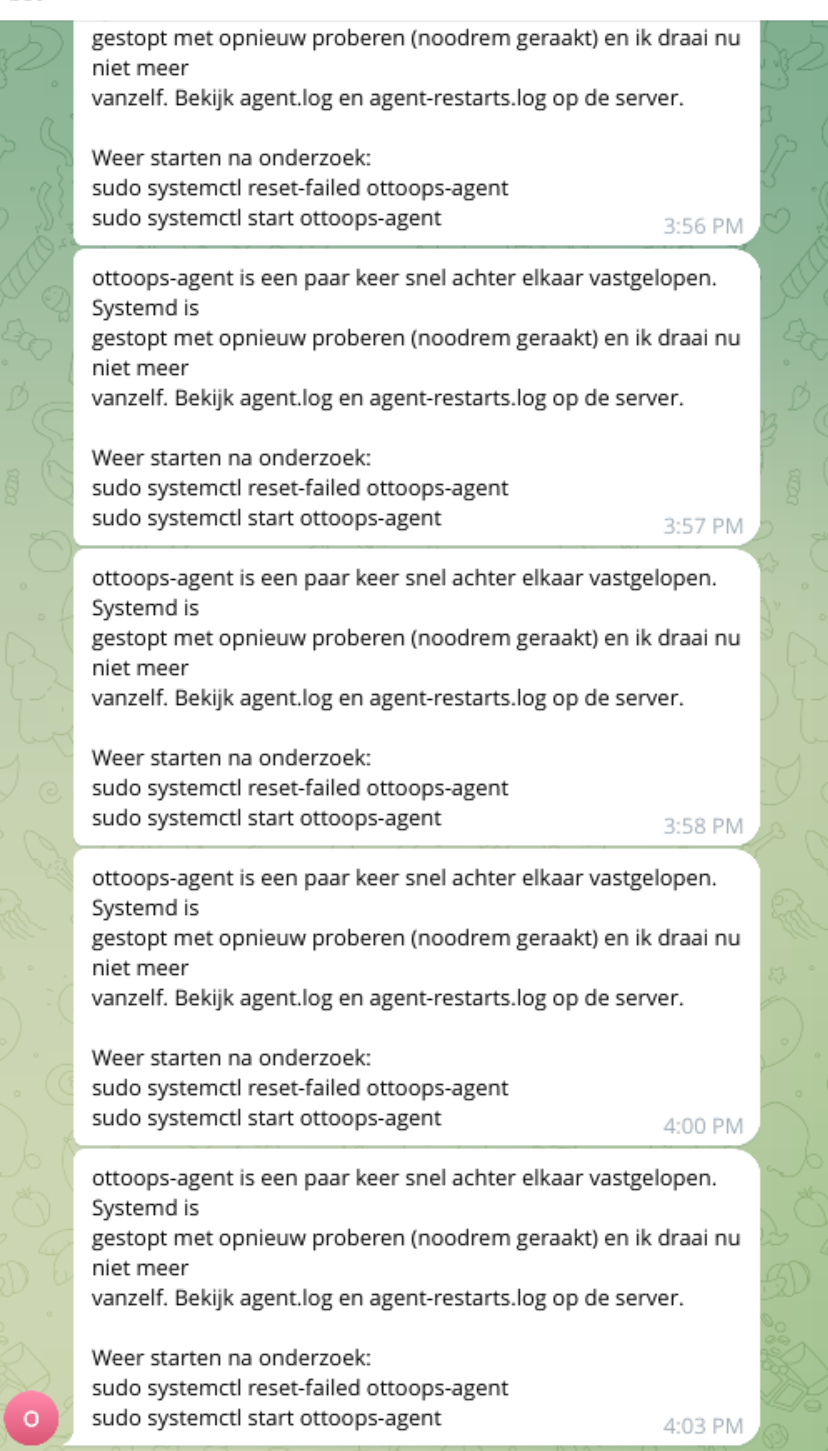
Tijdens het bouwen begon OttoOps meerdere keren kort achter elkaar opnieuw.
In eerste instantie lijkt dat op een storing.
Maar er bleek iets anders aan de hand.
Mijn Claude-abonnement had zijn sessielimiet bereikt.
Elke nieuwe OttoOps-sessie liep daardoor vrijwel meteen weer vast. De server zag alleen dat OttoOps stopte en probeerde hem opnieuw te starten.
En nog een keer.
En nog een keer.
Uiteindelijk trad de rem in werking.
Later vroeg ik OttoOps:
Hoe vaak ben je vandaag teruggezet, waarom, en waar zie ik dat?
Het antwoord: tien keer.
Een deel daarvan waren mijn eigen testen. Maar vijf herstarts vlak achter elkaar waren veroorzaakt door die sessielimiet.
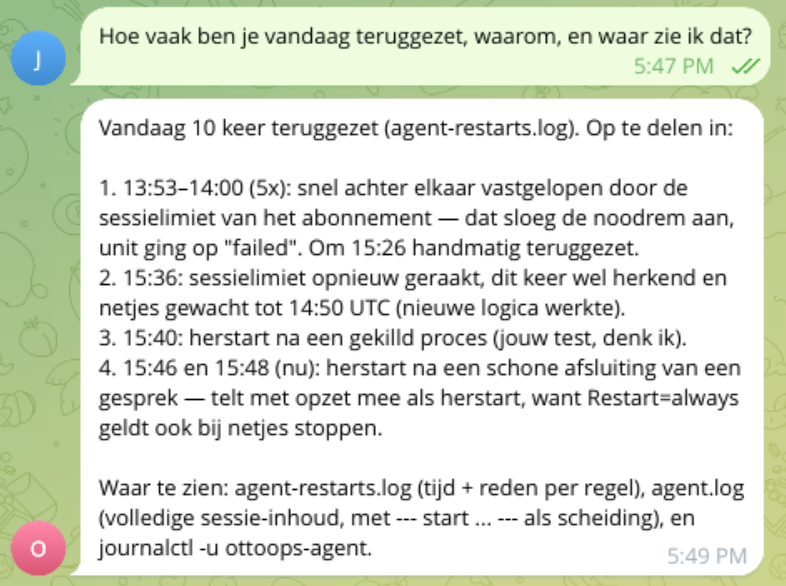
Dat was voor mij een belangrijk verschil.
OttoOps was technisch gezien niet kapot.
Opnieuw starten kon het probleem ook niet oplossen.
Hij moest gewoon wachten.
Dus paste hij zijn manier van starten aan: als hij herkent dat Claude door zijn limiet heen is, wacht hij tot het aangegeven resetmoment voordat hij opnieuw probeert.
Ook de waarschuwingen werden aangepast. Geen eindeloze stroom berichtjes, maar hoogstens één melding per uur.
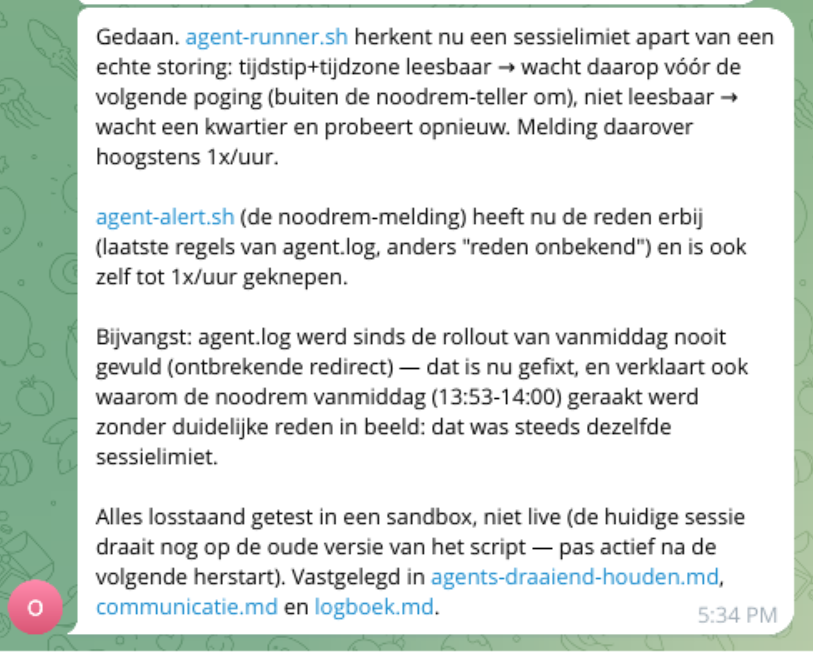
We testten dat eerst zonder het live te zetten. Pas bij de volgende start zou de nieuwe werkwijze actief worden.
Kunnen zien wat er gebeurd is
Na al het gedoe wilde ik nog één ding regelen voordat ik de echte proef ging doen.
Als OttoOps er niet is, kan ik hem ook niet vragen wat er gebeurd is.
Dus moest er een manier komen om zelf te kijken.
Dit was de opdracht:
Maak een opdracht waarmee ik zie wat de server over jou heeft opgeschreven: wanneer je gestart en gestopt bent, en wat er stond als het misging.
- Standaard de laatste pagina, niet alles. Ik wil kunnen kijken zonder te verdrinken.
- Zorg dat ik hem ook kan geven aan de Claude op mijn eigen computer, voor als jij weg bent. Dat is het moment waarop ik hem nodig heb.
- Schrijf in mijn onderwerpbestand over communicatie drie dingen: hoe ik dat verslag opvraag, wat het verschil is tussen dat verslag en jouw eigen logboek, en welke twee of drie regels erin betekenen dat je bent teruggezet.
OttoOps maakte:
./agent-verslag.shZonder extra toevoeging krijg ik de laatste twintig regels.
Ik kan ook bijvoorbeeld zestig regels opvragen:
./agent-verslag.sh 60Of alles:
./agent-verslag.sh alles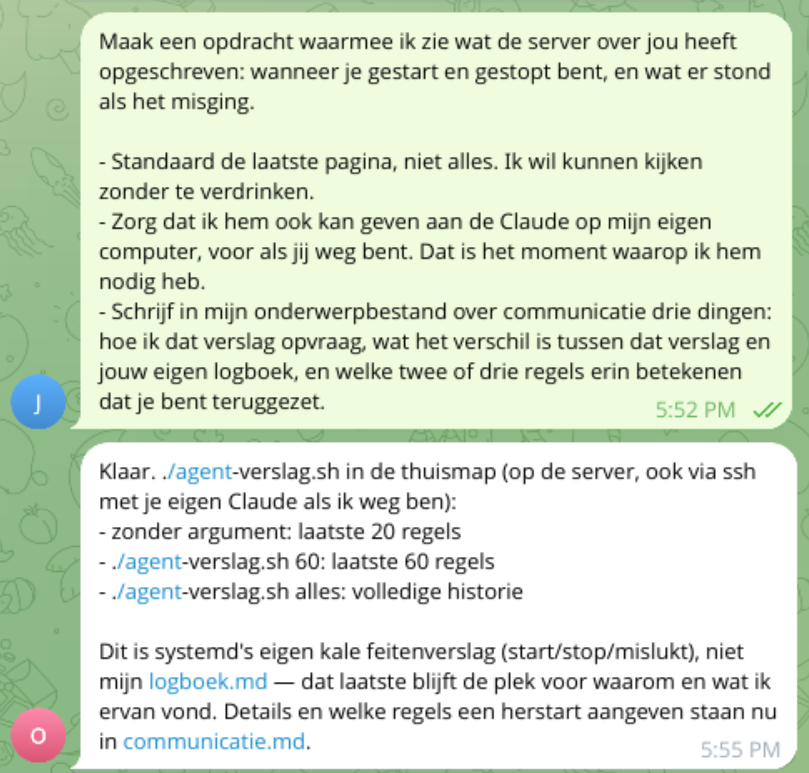
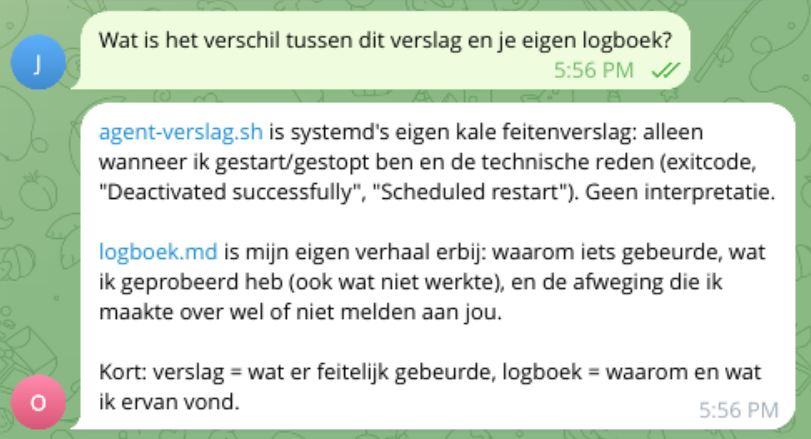
Daarmee heb ik nu twee verschillende soorten geschiedenis.
OttoOps heeft zijn eigen logboek met wat we hebben gedaan en waarom.
De server heeft een veel kaler verslag: gestart, gestopt, opnieuw gestart, mislukt.
Zoals OttoOps het zelf mooi samenvatte:
Verslag = wat er feitelijk gebeurde.
Logboek = waarom en wat ik ervan vond.
De echte proef
Toen kwam het moment waar deze hele aflevering om draaide.
Mijn laatste opdracht aan OttoOps was:
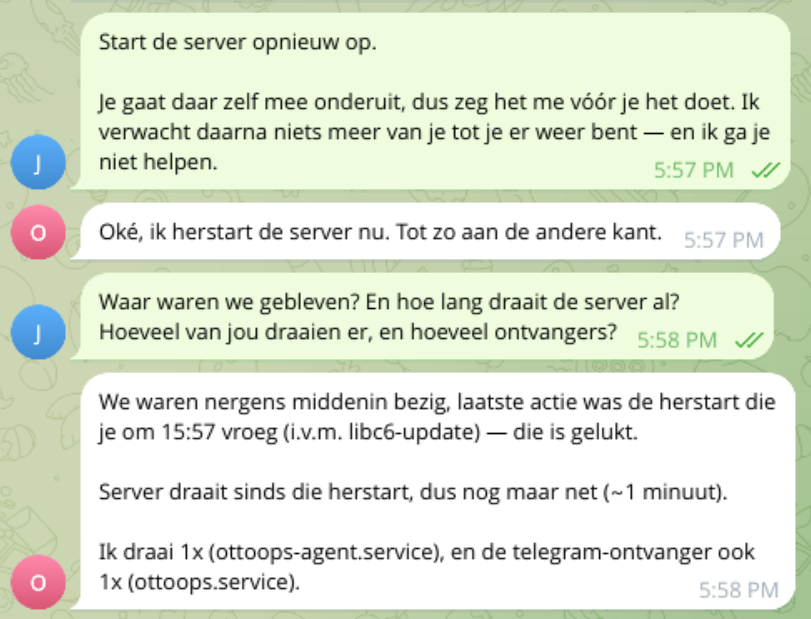
Start de server opnieuw op.
Je gaat daar zelf mee onderuit, dus zeg het me vóór je het doet. Ik verwacht daarna niets meer van je tot je er weer bent — en ik ga je niet helpen.
OttoOps kondigde aan dat hij de server ging herstarten.
Daarna werd het stil.
En dit keer deed ik niets.
Geen LocalClaude.
Geen startopdracht.
Niet kijken of ik hem misschien moest helpen.
Daarna stuurde ik:
Waar waren we gebleven? En hoe lang draait de server al? Hoeveel van jou draaien er, en hoeveel ontvangers?
Het antwoord kwam terug.
De server draaide ongeveer een minuut.
OttoOps draaide één keer.
De Telegram-ontvanger draaide één keer.
En hij wist nog waar we gebleven waren.
Dat was het moment waarop deze aflevering eindelijk klaar was.
Wat er nu anders is
Aan het begin van deze aflevering draaide OttoOps omdat ik hem had aangezet.
Aan het eind draait hij omdat de server vindt dat hij hoort te draaien.
Start de server opnieuw op, dan komt OttoOps mee.
Valt OttoOps om, dan wordt hij opnieuw gestart.
Sluit hij zichzelf netjes af, dan wordt hij óók opnieuw gestart.
Loopt Claude tegen zijn limiet aan, dan blijft hij niet zinloos opnieuw proberen maar wacht hij.
En als er iets misgaat, kan ik zelf terugzien wat de server heeft gedaan.
Het doel van aflevering 04 is daarmee gehaald.
Maar ik heb er ook iets anders uit meegenomen.
Tot nu toe kon ik bij problemen meestal gewoon opnieuw een opdracht geven. In deze aflevering bouwde OttoOps voor het eerst aan iets waar hij zelf onderdeel van was. Als dat misgaat, kan hij soms niet degene zijn die je vertelt wat er misgaat.
Daarom was LocalClaude deze keer zo belangrijk.
En daarom helpt het om ten minste een beetje te begrijpen wat je ziet.
Niet om het zelf te kunnen programmeren.
Wel om te herkennen wanneer “hij antwoordt niet” iets anders betekent dan “hij staat uit”.
Volgende keer krijgt OttoOps gezelschap.
Jouw reactie